

OpenAI เปิดชิป Jalapeño กับ Broadcom: inference กลายเป็นสนามหลักของ AI infrastructure
สารบัญบทความ (Table of Contents)
ข่าว Hardware / Infrastructure สำหรับรอบวันที่ 26 มิถุนายน 2026 คือ OpenAI และ Broadcom เปิดตัว Jalapeño ชิป inference รุ่นแรกที่ OpenAI เรียกว่า Intelligence Processor เมื่อวันที่ 24 มิถุนายน 2026
ประกาศทางการของ OpenAI ระบุว่า Jalapeño เป็น accelerator ที่ออกแบบตั้งแต่ต้นสำหรับงาน LLM inference ไม่ใช่ชิป training หรือ accelerator ทั่วไปที่เอามาปรับใช้กับโมเดลภาษา
Broadcom ระบุในข่าวนักลงทุนวันเดียวกันว่า Jalapeño จะเป็นส่วนหนึ่งของ compute platform หลายเจเนอเรชัน และจะถูก deploy ระดับ gigawatt scale กับ data center partners เริ่มในปี 2026
ทำไม inference จึงกลายเป็นข่าว hardware ใหญ่
ช่วงแรกของ generative AI ทุกคนจับตา training เพราะการสร้าง frontier model ต้องใช้ GPU cluster ขนาดใหญ่ แต่ในปี 2026 ภาระเริ่มย้ายมาที่ inference อย่างชัดเจน
ถ้าผู้ใช้เรียก ChatGPT, Codex, API และ agentic workflow ตลอดเวลา ต้นทุนที่เกิดซ้ำทุกวันคือการ serve model ให้เร็ว เสถียร และถูกพอ ไม่ใช่แค่การ train model หนึ่งครั้ง
Jalapeño จึงน่าสนใจเพราะ OpenAI ออกแบบ hardware จากมุมของ operator ที่รู้ workload ของตัวเองลึกมาก:
- kernel ที่ใช้จริงใน LLM
- memory movement ระหว่างชั้นของ model
- serving pattern ของ ChatGPT, Codex และ API
- latency requirement ของ interactive product
- networking ระดับ rack และ data center
- cost ต่อ token ที่ต้องลดลงเพื่อ scale usage
นี่คือ logic ของ full-stack AI infrastructure: บริษัทที่คุม model, product, serving software และ demand curve ย่อมอยากคุม silicon มากขึ้นด้วย
9 เดือนจาก design ถึง tape-out
รายละเอียดที่แรงที่สุดคือ OpenAI และ Broadcom ระบุว่า Jalapeño พัฒนาจาก design ไปถึง manufacturing tape-out ภายใน 9 เดือน
สำหรับ high-performance ASIC ระดับนี้ timeline ดังกล่าวเร็วมาก เพราะวงจรปกติของการออกแบบ chip, verify, physical implementation และ tape-out มักกินเวลานานกว่านั้นมาก
OpenAI บอกว่าความเร็วนี้มาจาก software-hardware co-development ระหว่างทีมวิศวกรรมของ OpenAI กับความเชี่ยวชาญด้าน silicon implementation ของ Broadcom รวมถึงการใช้โมเดลของ OpenAI ช่วยเร่งบางส่วนของ design และ optimization process
ถ้าข้ออ้างนี้พิสูจน์ได้จริง มันจะมีผลกว้างกว่า Jalapeño เอง เพราะ AI จะไม่ได้เป็นแค่ workload ที่ต้องใช้ชิป แต่เริ่มเป็นเครื่องมือช่วยออกแบบ infrastructure รุ่นถัดไปด้วย
ยังไม่มี benchmark เต็ม แต่สัญญาณชัด
OpenAI ระบุว่า engineering samples ของ Jalapeño กำลังรัน ML workload ใน lab ที่ target frequency และ target power รวมถึง workload ที่อ้างถึง GPT-5.3-Codex-Spark
บริษัทยังบอกว่า early testing แสดง performance per watt ที่ดีกว่า current state-of-the-art อย่างมีนัยสำคัญ แต่ยังไม่ได้เผยแพร่ technical report ฉบับเต็ม โดยบอกว่าจะตามมาในอีกไม่กี่เดือน
จุดนี้ต้องอ่านอย่างระมัดระวัง:
- ยังไม่มีตัวเลข benchmark สาธารณะ
- ยังไม่รู้ production yield และ supply chain economics
- ยังไม่รู้ workload mix ที่ใช้เทียบ
- ยังไม่รู้ว่า deployment จริงจะลด cost ต่อ token ได้เท่าไร
- แต่สัญญาณเชิงกลยุทธ์ชัดว่า OpenAI ไม่ต้องการพึ่ง GPU merchant market เพียงทางเดียว
สำหรับตลาด hardware ข่าวนี้กดดัน NVIDIA, AMD, Google TPU และ custom silicon ของ hyperscaler ทั้งหมด เพราะ inference ไม่ได้ต้องการแค่ peak FLOPS แต่ต้องการ latency, memory bandwidth, networking และ utilization ที่ดีใน production
Broadcom และ Celestica ทำให้เรื่องนี้เป็น infrastructure platform
OpenAI ไม่ได้ประกาศชิปแบบเดี่ยว ๆ แต่ประกาศเป็น platform ที่มี partner หลายชั้น
Broadcom ทำ silicon implementation และ networking technology เช่น Tomahawk ส่วน Celestica ถูกระบุในบทบาท board, rack และ system expertise
นี่ทำให้ Jalapeño ไม่ใช่แค่ die หรือ accelerator card แต่เป็นความพยายามสร้าง AI factory stack ตั้งแต่ชิปไปจนถึง rack และ data center deployment
เหตุผลคือ LLM inference ที่ scale ใหญ่ไม่ได้ติด bottleneck ที่ชิปอย่างเดียว:
- memory ต้องพอกับ model และ context
- network ต้องจัดการ traffic ระหว่าง accelerator
- serving scheduler ต้องเติมงานให้ hardware เต็ม
- power และ cooling ต้องรองรับ density
- software stack ต้องลด overhead ที่ทำให้ utilization หาย
ถ้า OpenAI optimize ทุก layer ได้จริง ข้อได้เปรียบจะไม่ได้อยู่ที่ราคาชิปอย่างเดียว แต่อยู่ที่จำนวน token ต่อ watt และ token ต่อดอลลาร์ในระบบ production
มุมมองของผม
ผมมองว่า Jalapeño เป็นข่าว hardware/infrastructure ที่สำคัญมาก เพราะมันบอกว่า AI boom กำลังเข้าสู่ยุคที่ inference economics สำคัญเท่ากับ model quality
OpenAI ไม่ได้แค่ซื้อ compute เพื่อใช้โมเดล แต่กำลังออกแบบ compute ให้ตรงกับโมเดลของตัวเอง นี่คือทิศทางเดียวกับที่ hyperscaler สร้าง custom silicon แต่มีน้ำหนักพิเศษเพราะ OpenAI เป็นทั้ง model lab, product company และ API platform ขนาดใหญ่
สิ่งที่ต้องจับตาต่อคือ technical report, deployment จริงปลายปี 2026, partner data center, และ cost ต่อ token เมื่อเทียบกับ GPU cluster รุ่นล่าสุด ถ้าตัวเลขออกมาดี ตลาด inference accelerator จะร้อนขึ้นมาก
สรุปสั้น ๆ: วันที่ 24 มิถุนายน 2026 OpenAI และ Broadcom เปิดตัว Jalapeño ชิป inference สำหรับ LLM ที่พัฒนาถึง tape-out ใน 9 เดือน ข่าวนี้สะท้อนว่า AI infrastructure ปี 2026 กำลังเปลี่ยนจากการซื้อ GPU ทั่วไปไปสู่ full-stack custom inference platform
หมายเหตุเรื่องภาพประกอบ
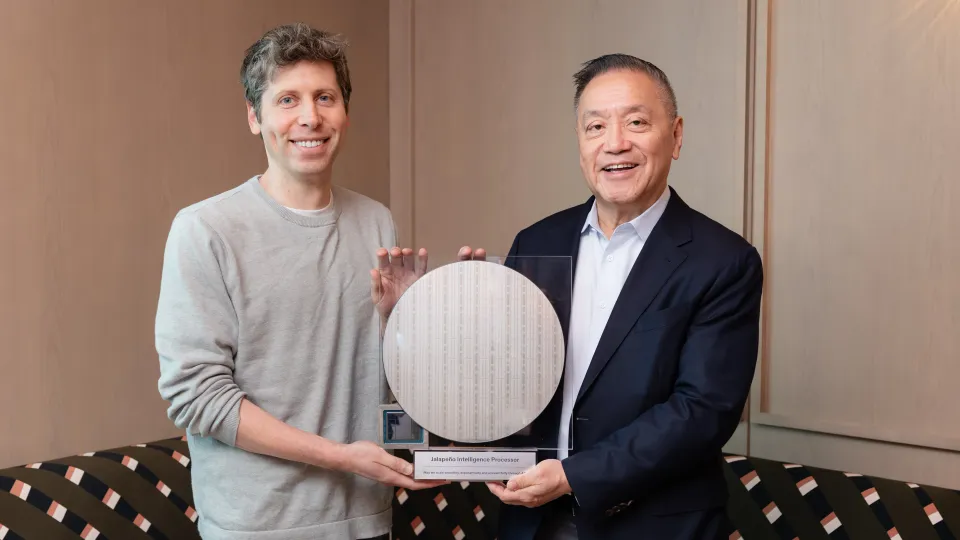
ภาพประกอบบทความนี้ดาวน์โหลดจากภาพทางการของ OpenAI สำหรับข่าว Jalapeño ขนาด 3840x2161 พิกเซล ผ่านข้อกำหนด cover image ของ repo
แหล่งอ้างอิง
About the Author

บทความที่เกี่ยวข้อง (Related Posts)
Broadcom ทำ AI semiconductor revenue 16.7 พันล้านดอลลาร์: custom accelerator กำลังเป็นแกนใหม่ของ infrastructure
สรุปข่าว Hardware / Infrastructure วันที่ 3 กันยายน 2026 เรื่อง Broadcom รายงาน Q3 FY2026 พร้อม AI semiconductor revenue 16.7 พันล้านดอลลาร์ และคาด Q4 แตะ 21.7 พันล้านดอลลาร์
Qualcomm Dragonfly HBC: เมื่อมือถือชิปยักษ์ใหญ่ลงสนาม AI data center แบบเต็ม stack
สรุปข่าว Qualcomm Investor Day วันที่ 24 มิถุนายน 2026 ที่เปิด Dragonfly C1000, High Bandwidth Compute และ AI300 inference accelerator เพื่อบุก data center ยุค agentic AI
Bloom Energy Mid-Year Pulse 2026: AI data center ไม่ได้ติดแค่ไฟฟ้า แต่ติด community, cost และ readiness gap
สรุปข่าว Bloom Energy เผย 2026 Data Center Power Report Mid-Year Pulse วันที่ 15 มิถุนายน 2026 ระบุ power ยังเป็นคอขวดหลักของ AI data center แต่ community scrutiny และ architecture readiness เริ่มสำคัญขึ้น
NVIDIA ซื้อ Hugging Face: model hub กลายเป็น infrastructure layer ที่ชิปยักษ์ต้องถือเอง
สรุปข่าว Hardware / Infrastructure วันที่ 8 กันยายน 2026 เรื่อง NVIDIA ประกาศซื้อ Hugging Face เพื่อขยายโครงสร้างพื้นฐาน open model, evaluation, inference และ deployment